服务提供方式
提供本地部署(On-Premise)与 API 集成(API Integration)两种服务模式
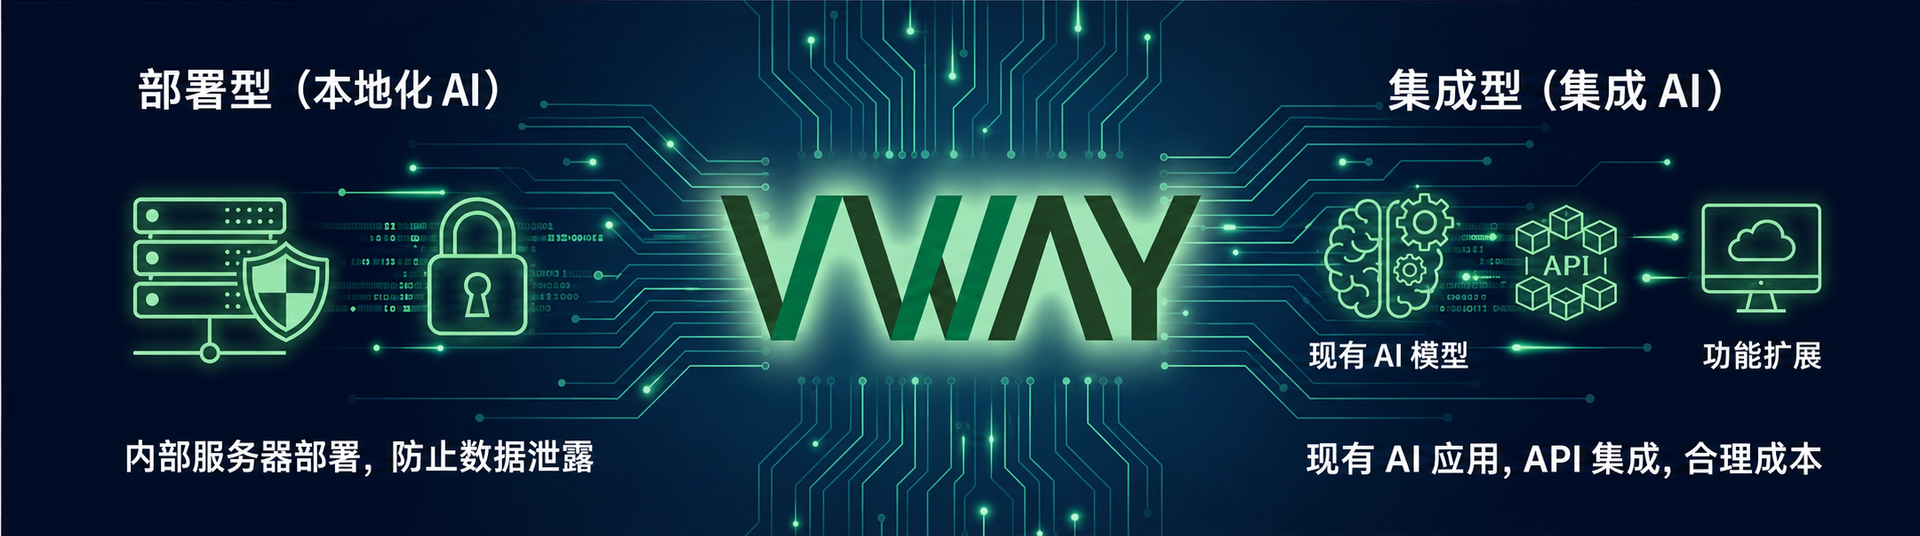
数据零外泄,打造专属于企业的专用 AI
专为对信息安全要求极高的国防、汽车、半导体等行业打造。
在与外部网络完全隔离的内部服务器中,基于成熟可靠的开源大语言模型(LLM),为企业构建专属的小型语言模型(sLLM)。
1. 核心技术:领域专属微调(Fine-tuning)
通用 AI 难以理解企业复杂的需求规格说明书(SRS)、遗留代码(Legacy Code)以及专业工程知识。
VWAY 基于性能经过验证的开源模型,结合企业专有工程数据进行微调(Fine-tuning),打造真正符合业务需求的 AI。
可广泛应用于:
安全分析(Safety Analysis)
需求验证(Requirements Verification)
测试用例生成(Test Case Generation)
代码审查(Code Review)
在特定工程领域实现接近专家级的分析能力。
2. 提升准确率:RAG(Retrieval-Augmented Generation)系统
AI 出现"幻觉(Hallucination)"并生成错误信息,在工程领域可能带来严重风险。
为此,VisualPro AI 引入了 RAG(检索增强生成) 架构。
工作原理: 在生成回答之前,AI 会先从企业内部技术文档库(Vector Database)检索相关规范、手册及技术资料,再依据检索结果生成回答。
优势有效避免 AI 无依据生成内容
提供可靠的数据来源
支持引用具体文档,例如:
"根据参考文档第 34 页……" 进一步提升分析结果的可信度。
*参考技术:https://www.nvidia.com/en-us/glossary/retrieval-augmented-generation/
最大化利用现有 AI 资源,实现最快速、最高效的能力扩展
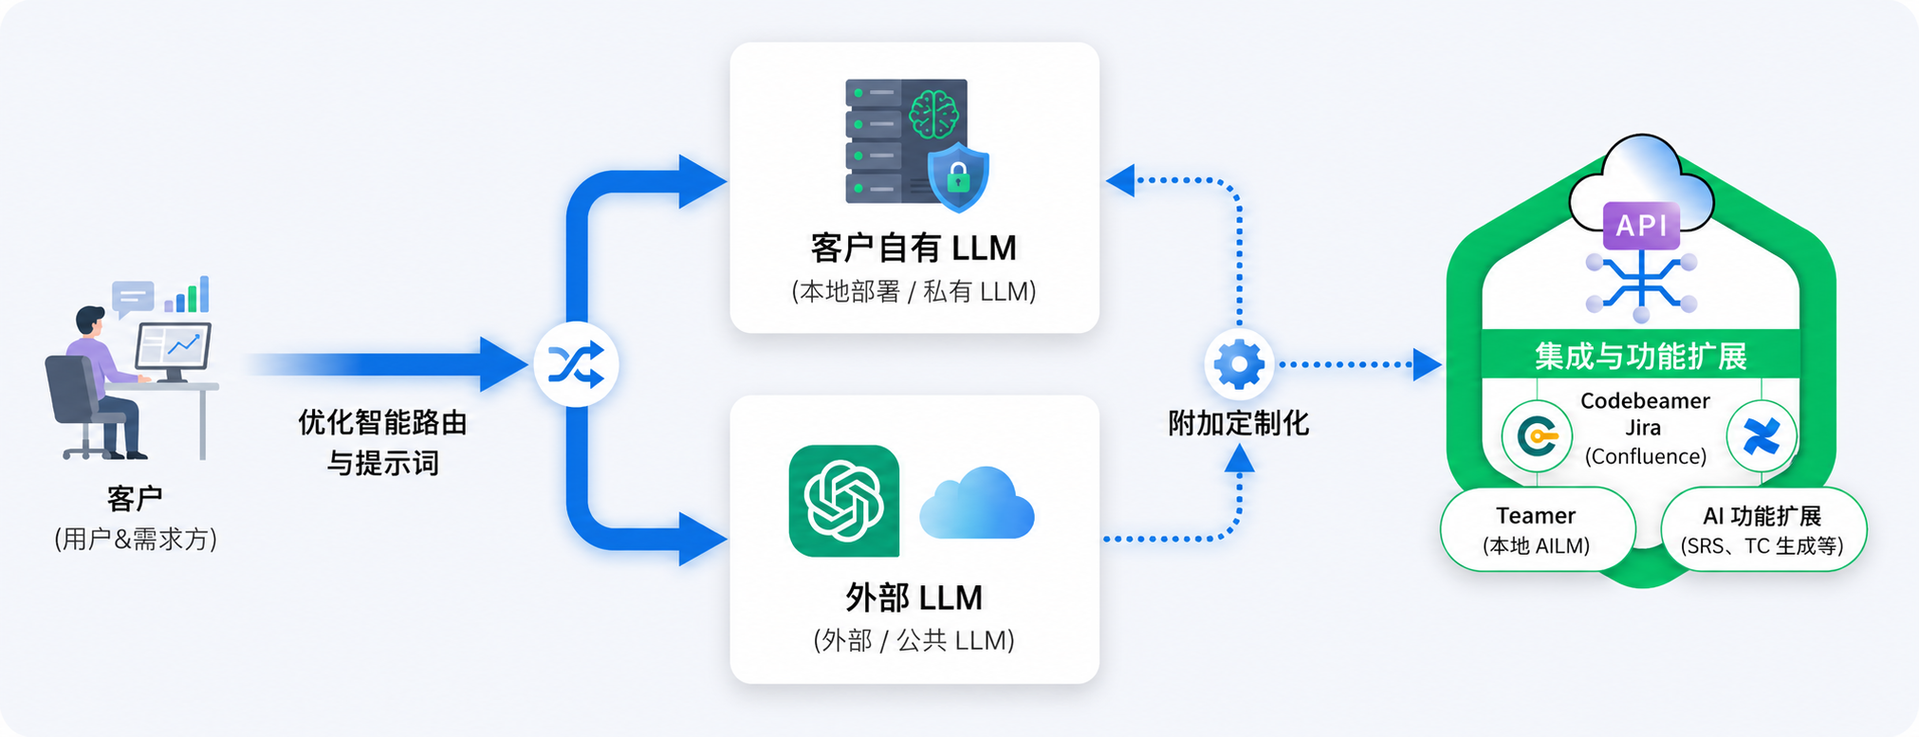
适用于已经部署或正在使用 GPT-4、Azure OpenAI、Claude 等大型 AI 模型的企业。
无需重新训练模型,只需通过 API 将 VWAY 的工程化 Prompt 模块与企业现有 AI 连接,即可快速扩展专业能力。
1. 降低成本,兼顾高性能
无需承担模型训练及服务器部署等资本投入(CAPEX),即可充分利用现有 AI 基础设施。
VWAY 以 API 形式提供针对企业业务场景优化的 Prompt Engineering 与分析逻辑,包括:
SRS 需求验证
自动化测试
工程分析等
帮助企业快速构建高性能 AI 应用。
2. 速度与效率优化:Semantic Caching
针对 API 调用模式中常见的响应延迟(Latency)及 Token 成本问题,VisualPro AI 引入 Semantic Caching(语义缓存) 技术。
技术原理: 系统将用户问题转换为向量(Vector)并进行缓存。例如,当用户提出:"请根据 ISO 26262 对 ASIL 等级进行分类" 若系统检测到历史中存在语义相近的问题,则无需再次调用 AI 模型,而是直接从缓存中返回结果。
优势
大幅提升响应速度
显著减少重复 API 调用
有效降低 Token 使用成本
提升整体系统运行效率